
過去幾篇中,我們逐步放寬了對 representation 的想像。一開始,我們假設某個 concept 可以用一條 direction 表示;接著,我們用 Conceptors 把一條線擴展成多維 subspace。但 direction 和 subspace 仍然共享一個假設:Concept 的 representation 是平坦的。一條 direction 是直線;一個 subspace 則是更高維的平面。然而,現實世界中的概念往往帶有更豐富的結構。星期一和星期二很接近,星期一和星期日也很接近;一月同時鄰近二月和十二月。這些概念並不是排在一條有起點和終點的直線上,而是形成一個循環。如果模型真的理解了這些關係,它的 internal representation 會不會也保留相似的形狀?
想像模型使用二維空間表示一星期中的七天:
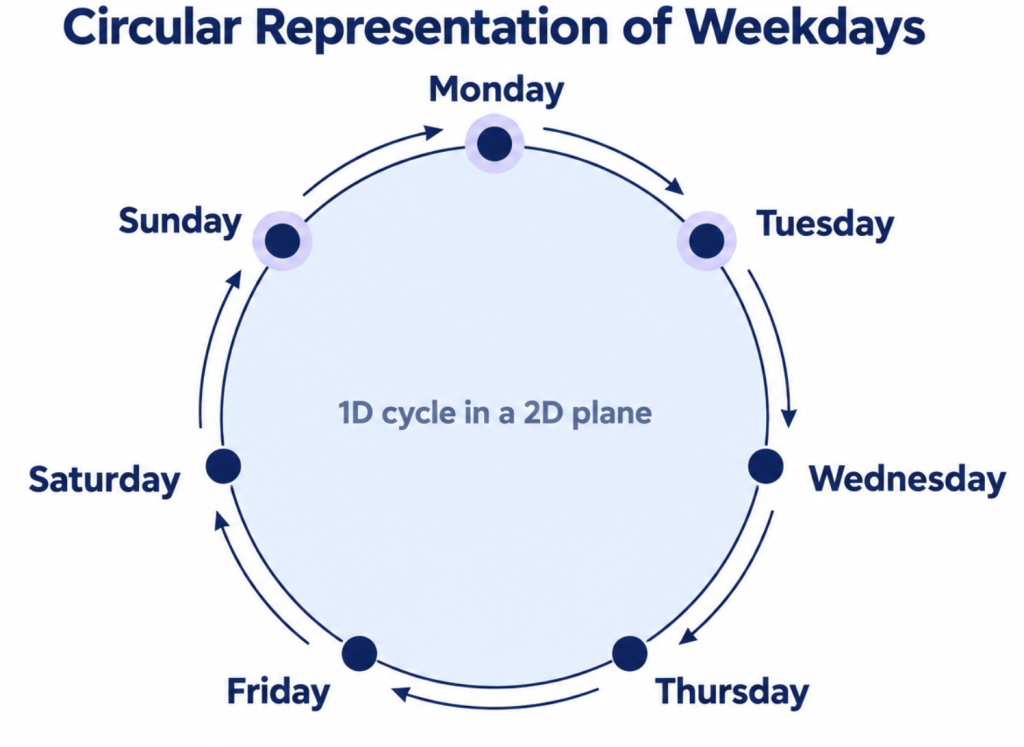
在這個空間裡(1D circle 的意思是圓周本身是一維,只有沿圓周移動這一個自由度,One angle locates a point on the circle):
這些幾何關係剛好反映星期本身的結構。
一條直線很難自然地同時表達:
Sunday 接近 Monday
Monday 接近 Tuesday
但一個圓可以。
這種彎曲、低維,卻嵌入在高維空間中的幾何結構,通常可以稱作 manifold(流形)。一個圓的 intrinsic dimension 其實只有一維:只要知道沿著圓走了多遠,就能決定所在位置。但它至少需要嵌入二維空間,才能形成圓形。同樣地,一個 concept manifold 可能只有少數幾個真正重要的自由度,卻存在於數千維的 activation space 中。
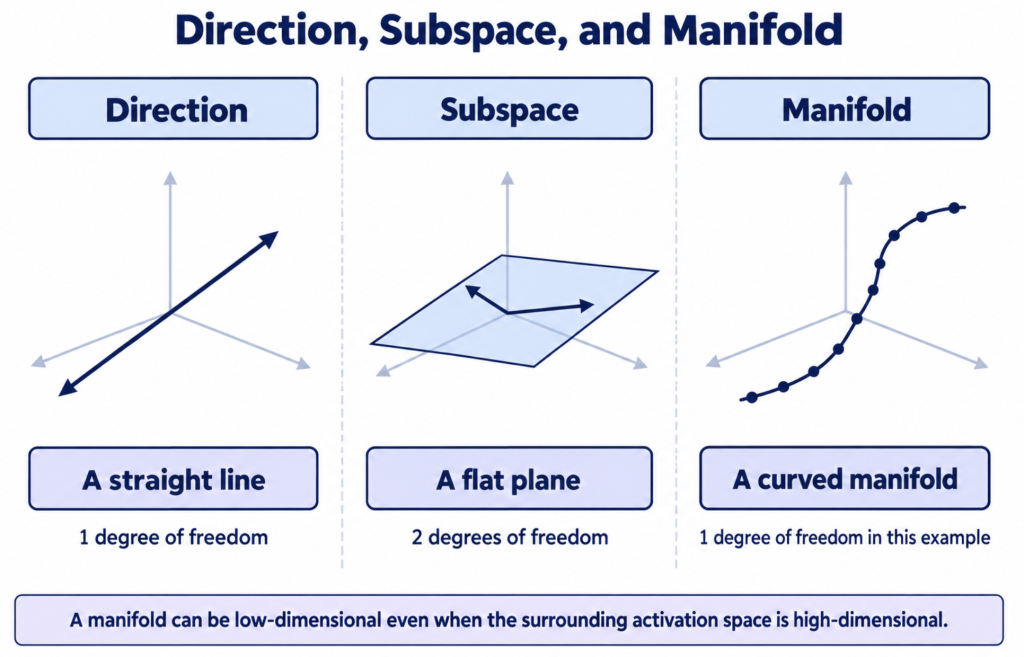
因此,manifold 並不是「另一種更高維的 direction」。真正的差別在於:它可以是彎曲的,而且不同位置之間具有自己的鄰近、順序與距離關係。
近年的研究確實在語言模型中發現許多具有結構的 representation。例如,Engels 等人從 GPT-2 與 Mistral 7B 中找到星期與月份的圓形 representations。他們不只看到 Monday, Tuesday, Wednesday 依序排列在圓周上,也發現 weekend 會落在 Saturday 和 Sunday 附近,winter 則會出現在 December 和 January 之間。[1]
這表示幾何空間保存的不只是七個或十二個彼此獨立的 labels。它還保存了它們之間的關係。Goodfire 的 Neural Geometry 系列也整理了其他例子:[2]
這些結果提供了一個很不一樣的視角:模型可能不只是儲存一群互相獨立的 concepts,而是建立了一個具有形狀的內部世界。
模型的 representation 並不是憑空產生的。訓練資料本身就反映了現實世界的結構。月份會以特定順序出現;相鄰月份常出現在相似的語境中;December 之後通常接著 January,而不是 June。描述相近顏色的詞,也會出現在彼此相似的 context 中。
模型為了有效預測這些資料,有動機把彼此相關的概念放在 activation space 中相近的位置:如果 December 和 January 的 representation 離得夠近,模型就能用同一組權重去處理「December 後面接著 X」這類模式,並自然泛化到「November 後面接著 December」,而不需要為每一組相鄰月份分別記住一條規則。換句話說,把相近的概念放在相近的位置,是一種讓 next-token prediction 更省參數、更容易泛化的做法——模型可能逐漸建立出能保留這些關係的 representation。再換句話說:
外部世界的結構,透過訓練資料留下統計痕跡;模型的內部幾何,則可能是對這些結構的一種壓縮。
這不代表模型的 representation 必然和人類完全相同,也不代表每個概念都具有漂亮、低維的 manifold。但當 activation space 中的距離、鄰近與方向,穩定地對應到有意義的概念關係時,這些 geometry 本身就成為值得研究的對象。
只把高維 activation 投影到二維,再看到一個漂亮的圓,證據仍然不夠。Dimensionality reduction 本身可能扭曲資料;研究者也可能在大量 projections 中,剛好挑到一張看起來最有故事的圖。因此,我們至少還需要檢查:
Engels 等人不只找到星期與月份的圓形 representations,也對 Mistral 7B 和 Llama 3 8B 進行 intervention,測試模型在星期與月份的 modular arithmetic 中是否真的使用這些圓形結構。[1] 例如:
Two days after Monday is ___
他們先量出模型在這類題目上的基本表現:Mistral 7B 在 49 題星期運算中答對 31 題,144 題月份運算中答對 125 題,Llama 3 8B 星期 29/49、月份 143/144。有趣的是 GPT-2 雖然也有圓形 representation,實際運算準確率卻很低。這說明「內部有這個結構」和「模型真的拿它來算」是兩件要分開驗證的事。
接著他們做了介入:把模型算「Two days after Monday」算到一半時,直接把圓形子空間裡代表 Monday 的座標,替換成代表 Wednesday 的座標,其餘維度做 average-ablation。如果模型真的用這個圓在計算,輸出應該從原本的 Wednesday 變成 Friday(往後多推了兩天的圓周距離)。結果確實如此,而且光介入這個子空間,幾乎能達到介入整層一樣的效果。這表示圓形結構不只是 visualization artifact,而可能是模型實際進行 computation 時使用的對象。
這也讓我們重新思考 Sparse Autoencoder。標準 SAE 通常把每個 latent feature 寫成一個 decoder direction。那麼,當真正的 concept 是一條彎曲的 manifold 時,一群線性 directions 要怎麼表示它?2026 年的研究指出,SAE 大致可能採取兩種策略:[3]
使用一小組 features,它們共同張成一個足以容納整個 manifold 的 subspace。例如用兩條主要 directions,表示一個圓所在的平面。
使用許多 features,每個 feature 只負責 manifold 的一小段。
例如:
Feature A → Monday 附近
Feature B → Tuesday 附近
Feature C → Wednesday 附近
……
每一個 feature 看起來都可能相對單義,但只有把它們放在一起,才會看到完整的圓。
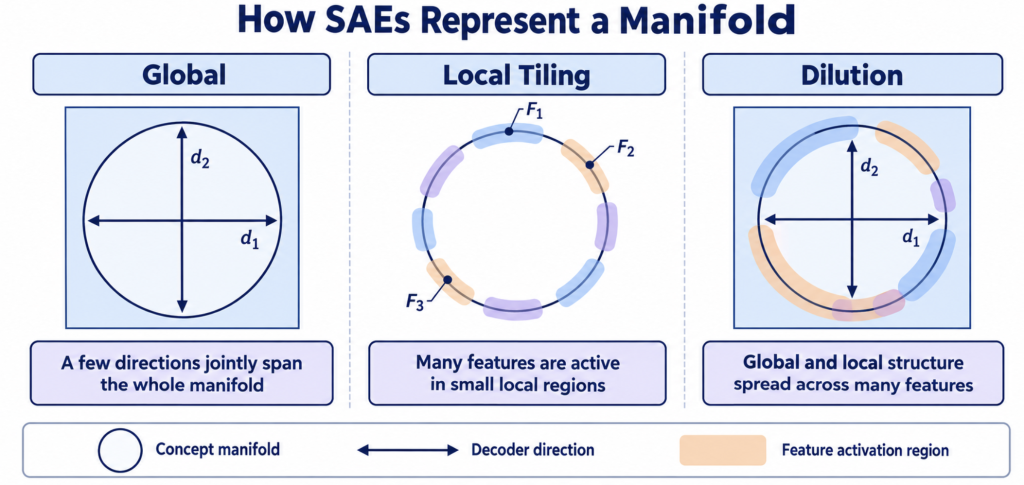
實際實驗中,SAE 往往不會乾淨地採用其中一種方式,而是形成介於 global representation 和 local tiling 之間的 fragmented 狀態。研究者的判斷方式是:去看單一 feature 的 decoder direction,能不能靠自己的線性張成空間撐起整個 manifold,如果不能,又只能覆蓋其中一小段弧,就代表這個 concept 被拆散到好幾個 feature 裡了。他們發現多數 concept 都落在這種中間地帶,沒有乾淨對應到純 global 或純 local 的例子,並把這種現象稱為 dilution。[3]
這也解釋了為什麼只看單一 SAE feature,可能會錯過更大的結構。例如,一條 representation manifold 可能按照韻腳的相似程度,從 perfect rhyme 平滑地走向 near rhyme。但自動替個別 SAE features 命名時,我們可能只得到一組看似互不相關的局部 labels,卻沒有發現它們其實共同排列在同一條 phonological curve 上。[2][3]
所以問題不一定是:「SAE 完全沒有捕捉到這個 concept。」更可能是:SAE 把整體 geometry 分散在許多 features 中,而我們選擇了錯誤的分析單位。
這帶出一個更根本的觀點。以前我們可能把 interpretability 想成:
找到 Feature #1234
↓
替它命名
↓
理解模型
但某些 concept 的意義,可能不在任何一個孤立 feature 裡,而在 features 之間的幾何關係。例如,January 的意義不只是「一月 feature 被啟動」。它的一部分意義來自:
如果只替每個位置各自貼標籤,就可能失去這些關係。因此,neural geometry 提出了一個可能的 right level of analysis:
真正有意義的單位,有時不是一個 neuron、direction 或 feature,而是一整個具有結構的 geometric object。
這不是在否定 Linear Probe、SAE 或 Conceptors。一條 direction 可能是 manifold 的局部切線;一個 subspace 可能包含整個 manifold;一組 SAE features 也可能共同拼出它。只是當我們解釋結果時,需要區分我們找到了整個 concept geometry,還是只看到了其中一小塊?
這一天的 companion notebook 會從不同 prompt templates 中收集 weekdays 或 months 的 hidden representations。但我們不只會做 PCA,因為一張漂亮投影本身不足以證明 circular representation。其中一個做法,是把星期編碼成角度:

接著訓練兩個簡單的 linear probes,分別預測:
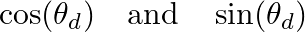
核心程式碼大致如下:
theta_train = 2 * np.pi * day_ids_train / 7

probe_cos.fit(
    H_train,
    np.cos(theta_train)
)

probe_sin.fit(
    H_train,
    np.sin(theta_train)
)
對 held-out prompts 預測後,再把兩個輸出當成平面座標:
coords = np.column_stack([
    probe_cos.predict(H_test),
    probe_sin.predict(H_test),
])
如果模型的 hidden states 真的保留 circular information,把 held-out prompts 的 (cos θ, sin θ) 畫在平面上、依星期上色,應該會看到七個顏色乾淨地按 Monday→Sunday 的順序排在圓周上,彼此間隔大致均勻。如果換成 shuffled-label control(把星期標籤打亂後重新訓練 probe),同樣畫出來則應該是一團沒有順序、沒有規律間隔的雜訊點。兩張圖放在一起對比,就是判斷這個結構是不是真實存在、而不是 PCA 湊巧生成的漂亮圖案的直接證據。
不過這個實驗仍然只能證明 circular coordinates 可以被讀出。要知道模型是否真的使用這個 geometry,仍然需要 intervention。而這正好帶出下一個問題。
標準 activation steering 會從起點到終點畫一條直線:
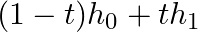
但如果自然 activations 實際上分布在一條彎曲的 manifold 上,直線就可能穿過一大片模型平常幾乎不會出現的區域。
結果可能像是:從 Monday 前往 Thursday 時,不是沿著 Tuesday、Wednesday 移動,而是直接穿過圓心瞬間傳送過去。
這也許可以到達終點,卻不一定形成自然、穩定或容易控制的中間 behavior。下一篇,我們會正式介紹 Manifold Steering:
比起在 activation space 中走直線,能不能沿著模型自然形成的 geometry 移動?
[1] Engels, J., Michaud, E. J., Liao, I., Gurnee, W., & Tegmark, M., “Not All Language Model Features Are One-Dimensionally Linear”, 2024. https://arxiv.org/abs/2405.14860
[2] Geiger, A., Lubana, E. S., Fel, T., et al., “The World Inside Neural Networks”, Goodfire Neural Geometry Series, 2026. https://www.goodfire.com/research/the-world-inside-neural-networks
[3] Bhalla, U., Fel, T., Rager, C., et al., “Do Sparse Autoencoders Capture Concept Manifolds?”, 2026. https://arxiv.org/abs/2604.28119


 iThome鐵人賽
 看影片追技術